存算一体技术
Author:周均扬
date: 2026.04.10
存算一体技术(Compute-in-Memory,简称CIM,也称存内计算或内存内计算)是一种突破传统冯·诺依曼架构的新型计算范式。其核心思想是将数据存储与计算功能融合在同一个芯片单元(或阵列)中,直接在存储器内部或紧邻位置完成运算,从而大幅减少数据在存储和计算单元之间频繁搬运带来的延迟与功耗。
1. 传统冯·诺依曼架构的瓶颈
传统计算机采用“存储-计算分离”架构:处理器(CPU/GPU)负责计算,内存(DRAM/SRAM)负责存储数据。每次运算都需要将数据从内存“搬”到处理器,运算完再写回。这种“数据搬运”在AI时代(尤其是深度学习的大量矩阵乘法/MAC运算)成为最大瓶颈:
- 存储墙(Memory Wall):处理器算力增长远超内存带宽,数据访问延迟成为瓶颈。
- 功耗墙(Power Wall):数据搬运功耗远高于实际计算(据NVIDIA数据,在22nm工艺下,数据传输功耗可达计算的200倍)。
冯·诺依曼架构示意图(经典分离式):

2. 存算一体技术的核心原理
存算一体将“存”和“算”界限模糊甚至消除,在存储阵列中直接嵌入计算电路(或利用存储器件本身的物理特性)完成运算。主要针对AI神经网络的核心操作——矩阵-向量乘法(VMM)和乘累加(MAC)。
- 模拟存算一体(主流于边缘AI):利用欧姆定律(电流=电压×电导)和基尔霍夫电流定律,在存储阵列中以模拟信号(电压/电流)形式实现并行乘加。权重存储在存储单元(如电阻状态),输入数据作为电压,输出电流自动累加后经ADC转换为数字结果。能效极高,但受噪声、温度影响,精度较低(适合低精度INT8等)。
- 数字存算一体:在存储单元内或周边添加数字逻辑电路(如加法树、移位器),以二进制方式精确运算。精度高、鲁棒性强,但面积和功耗相对较高。
典型存算一体架构示意图(以SRAM-CIM宏单元为例,可见子阵列并行计算):
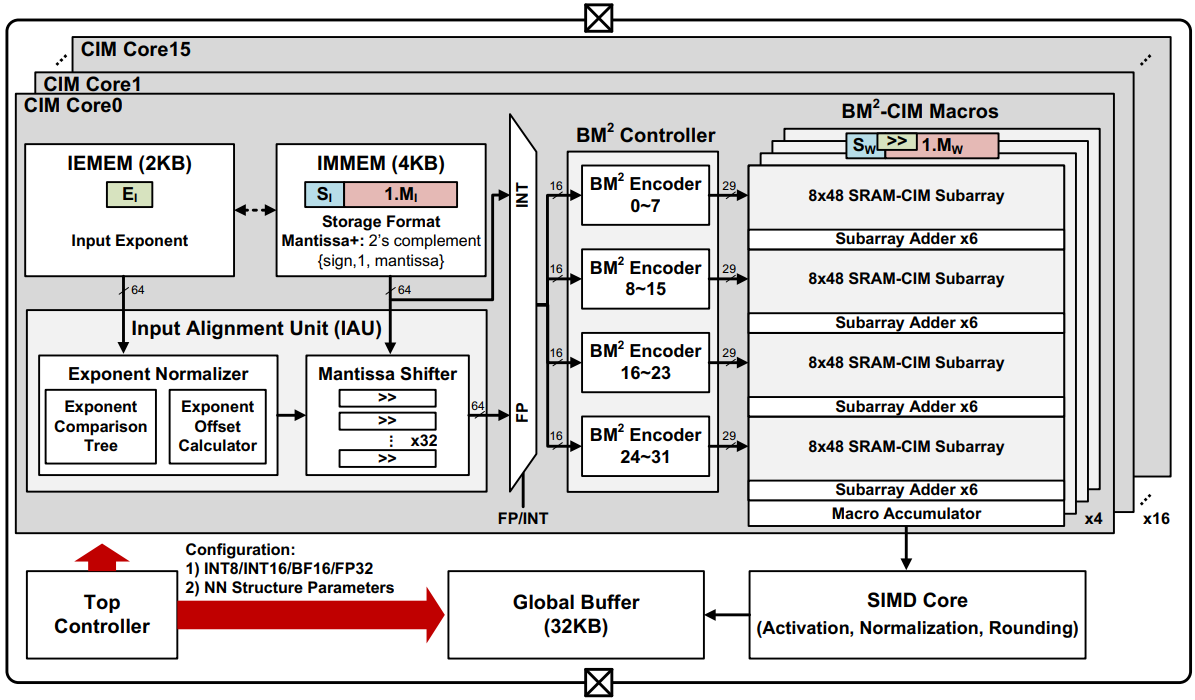
此外,还有 近存计算(Near-Memory Computing) 作为过渡:通过3D堆叠/HBM等技术缩短存算距离,但仍未完全融合。真正的存算一体是“存内计算”。
3. 主要技术路线(按存储介质分类)
存算一体芯片根据存储介质不同,呈现多元化发展:
| 介质类型 | 代表介质 | 优点 | 缺点 | 典型应用场景 | 成熟度 |
|---|---|---|---|---|---|
| 传统易失性 | SRAM | 工艺兼容性强、速度快、鲁棒性高 | 存储密度较低 | 边缘高性能AI推理 | 高(已量产) |
| 传统易失性 | DRAM | 密度高、成本低 | 刷新功耗、速度较慢 | 云端大模型 | 中 |
| 非易失性 | NOR Flash | 密度高、非易失 | 写入慢、 endurance 低 | IoT、低功耗设备 | 高 |
| 新型非易失性 | RRAM/ReRAM、MRAM、PCM、FeFET | 超低功耗、高密度、可扩展 | 工艺成熟度低、变异性大 | 未来云边端 | 研究/早期产业化 |
SRAM存算一体是当前最成熟路线之一,兼容标准逻辑工艺,易于SoC集成,支持高精度计算。
4. 突出优势
- 能效提升:数据搬运减少,能耗可降至传统架构的1/10~1/100;峰值能效可达10-100 TOPS/W以上。
- 算力密度与并行度:存储阵列天然支持大规模并行MAC运算,相当于在相同面积下“增加”大量计算核心。
- 延迟降低:消除访存瓶颈,适合实时边缘AI(如智能眼镜、耳机、机器人)。
- 成本与扩展性:在相对成熟工艺节点(如28nm)即可实现接近先进制程的性能,缓解摩尔定律放缓压力。
特别适用于AI推理场景,尤其大模型的云边端部署。
5. 主要挑战与技术壁垒
尽管前景广阔,存算一体仍面临实际落地难点:
- 精度与可靠性:模拟路线易受噪声、IR-drop、温度漂移影响;数字路线需解决峰值电流和电源稳定性。
- 设计与EDA工具:传统EDA不适配存算融合架构,缺乏成熟的自动综合、仿真平台。
- 系统集成:存算一体擅长矩阵运算,但标量/非线性运算仍需搭配传统处理器;片上缓存、软件生态(编译器、工具链)需重构。
- 工艺与量产:新型介质(如RRAM)良率低、变异性大;SRAM路线虽成熟,但大规模阵列的利用率和可测性仍是难题。
6. 发展现状与前景
- 全球现状:概念源于20世纪70年代,近年来随AI爆发加速。IBM、斯坦福、三星、TSMC等有原型芯片;中国在SRAM、RRAM等领域布局领先,已有小规模量产(如多家初创企业)。
- 中国优势:AI需求驱动+工艺灵活性,高校(如清华、北大)与企业紧密合作。预计2025年全球存算一体芯片市场超120亿美元,中国占比显著。
- 前景:被视为“后摩尔时代”AI芯片主流方向之一,与感存算一体(感知+存算融合)、类脑计算、多模态AI结合,将推动边缘智能设备爆发。未来趋势包括:混合模拟/数字、高精度训推一体、先进封装(Chiplet/3D)集成、与软件算法协同优化。
总体而言,存算一体技术正从实验室走向商用,是解决AI算力“存储墙+功耗墙”的关键路径之一。
7. Appendix,SRAM、DRAM、RRAM/ReRAM、MRAM、 NOR Flash、PCM、FeFET 的完整对比总结(基于最新发展情况,截至2026年)。
1. 全称(缩写展开)
- SRAM:Static Random Access Memory(静态随机存取存储器)
- DRAM:Dynamic Random Access Memory(动态随机存取存储器)
- RRAM / ReRAM:Resistive Random Access Memory / Resistive RAM(电阻式随机存取存储器)
- MRAM:Magnetoresistive Random Access Memory(磁阻式随机存取存储器,常指 STT-MRAM)
- NOR Flash:NOR 型闪存(一种传统非易失闪存,名称来自其内部逻辑门结构“NOR”)
- PCM:Phase Change Memory(相变存储器,也称 PCRAM 或 PRAM)
- FeFET:Ferroelectric Field-Effect Transistor(铁电场效应晶体管,也称 FeFET 内存,常基于 HfO₂ 铁电材料)
2. 工作原理简述
- SRAM:6 个晶体管组成触发器,靠电路状态保持数据。
- DRAM:1 个晶体管 + 1 个电容,靠电荷存储,需要定期刷新。
- RRAM/ReRAM:在介质中形成/断开导电细丝(氧空位或金属丝),改变电阻值。
- MRAM:利用磁隧道结(MTJ)的磁化方向或自旋转移扭矩改变电阻。
- NOR Flash:浮栅或电荷陷阱结构,通过热电子注入或 Fowler-Nordheim 隧道效应存储电荷。
- PCM:相变材料(如 GST)在非晶态(高阻)和晶态(低阻)之间切换,通过电流加热实现。
- FeFET:在 MOSFET 栅极叠加铁电层(通常 HfZrO),通过铁电极化方向改变晶体管阈值电压,实现非易失存储。
3. 主要区别对比表(关键特性)
| 特性 | SRAM | DRAM | NOR Flash | RRAM/ReRAM | MRAM | PCM | FeFET |
|---|---|---|---|---|---|---|---|
| 易失性 | 易失 | 易失 | 非易失 | 非易失 | 非易失 | 非易失 | 非易失 |
| 读写速度 | 最快(~1ns) | 较快(~10-50ns) | 中等(随机读较快) | 中等(10-100ns) | 很快(~2-20ns) | 中等(~50-100ns) | 很快(~10-100ns) |
| 功耗 | 较高(静态功耗大) | 高(需刷新) | 中等 | 很低(待机极低) | 很低 | 中等(写时需加热) | 很低 |
| 密度/成本 | 最低(6T/位,贵) | 高(廉价主存) | 中等(嵌入式常用) | 很高(交叉点阵列潜力大) | 中高 | 高(曾有3D XPoint) | 高(CMOS 兼容好) |
| 耐久性(写入周期) | 几乎无限 | 几乎无限 | 较低(10⁴~10⁵) | 中等(10⁶~10⁹) | 极高(>10¹²) | 高(10⁸~10¹²) | 很高(10⁷~10¹⁰+) |
| 刷新/擦除需求 | 无 | 需要刷新 | 需要块擦除 | 无 | 无 | 无 | 无 |
| 数据保留 | 需电源 | 需电源+刷新 | 10+ 年 | 数年~10年 | 10+ 年 | 10+ 年 | 10+ 年 |
| 典型用途 | CPU L1/L2 缓存 | 计算机主内存 | 嵌入式代码存储、固件 | 边缘AI、存算一体、低功耗存储 | 嵌入式替代 NOR/SRAM、汽车/IoT | 曾用于存储类内存(如 Optane) | 嵌入式非易失、存算一体、神经形态计算 |
4. 总结优缺点与应用场景
- SRAM:速度之王,但面积大、功耗高、成本高。仅用于最高速缓存。
- DRAM:容量与成本平衡最佳,仍是主内存绝对主力。但易失、需刷新。
- NOR Flash:传统嵌入式非易失存储的“老大哥”,随机读取较快,支持字节/字执行代码。但耐久性低、写入需擦除、难以在先进工艺(如<28nm)继续缩放。正在被 MRAM、ReRAM、FeFET 等新兴技术逐步替代(尤其在 MCU/嵌入式领域)。
- RRAM/ReRAM:高密度、低功耗、可做交叉点阵列,适合高密度非易失存储和存算一体(in-memory computing)。耐久性比 Flash 好,但仍需优化一致性和可靠性。目前在边缘 AI 和低功耗设备中商业化加速。
- MRAM(尤其是 STT-MRAM):非易失 + 速度快 + 耐久性极高 + 低功耗,被视为“通用内存”最强候选之一。特别适合替换嵌入式 NOR Flash 和部分 SRAM(断电不丢数据却像 RAM 一样快)。在汽车、工业、IoT 中已大规模商用,密度和成本持续改善。
- PCM(相变存储器):曾以 Intel/Micron 3D XPoint(Optane)闻名,兼具较高密度和较好性能。但写操作需加热(功耗相对较高),制造复杂,商业化遇到成本挑战。目前更多作为存储类内存(Storage Class Memory)概念存在,实际部署较少。
- FeFET:利用铁电极化实现非易失,CMOS 工艺兼容性极佳(可直接集成到标准逻辑流程),功耗低、耐久性好、支持多值存储和陡峭亚阈值摆幅。非常适合嵌入式非易失内存、神经形态计算(存算一体)和低功耗 AI 硬件。近年来 HfO₂ 基 FeFET 发展迅速,被视为替代 NOR Flash 和部分 DRAM 的潜力股,尤其在可穿戴、柔性电子等领域。
简单记忆口诀(扩展版):
- SRAM = 最快但最“胖”(缓存专用)
- DRAM = 主存王者,但要“喝水”(刷新)
- NOR Flash = 老代码存储,但“命短”(耐久低,难缩放)
- ReRAM = 电阻变 → 高密度 + 低功耗新星
- MRAM = 磁翻转 → 可靠、快、耐久强(最接近通用内存)
- PCM = 相变加热 → 曾是存储类希望,但成本高
- FeFET = 铁电极化 → CMOS 友好、低功耗、存算一体潜力大
这些新兴非易失内存(MRAM、ReRAM、FeFET、PCM)正在快速侵蚀 NOR Flash 的嵌入式市场,并试图打破“易失内存(SRAM/DRAM)+ 非易失存储(Flash)”的传统层次。未来可能实现真正的持久内存(Persistent Memory):断电不丢数据,却拥有接近 RAM 的读写速度。